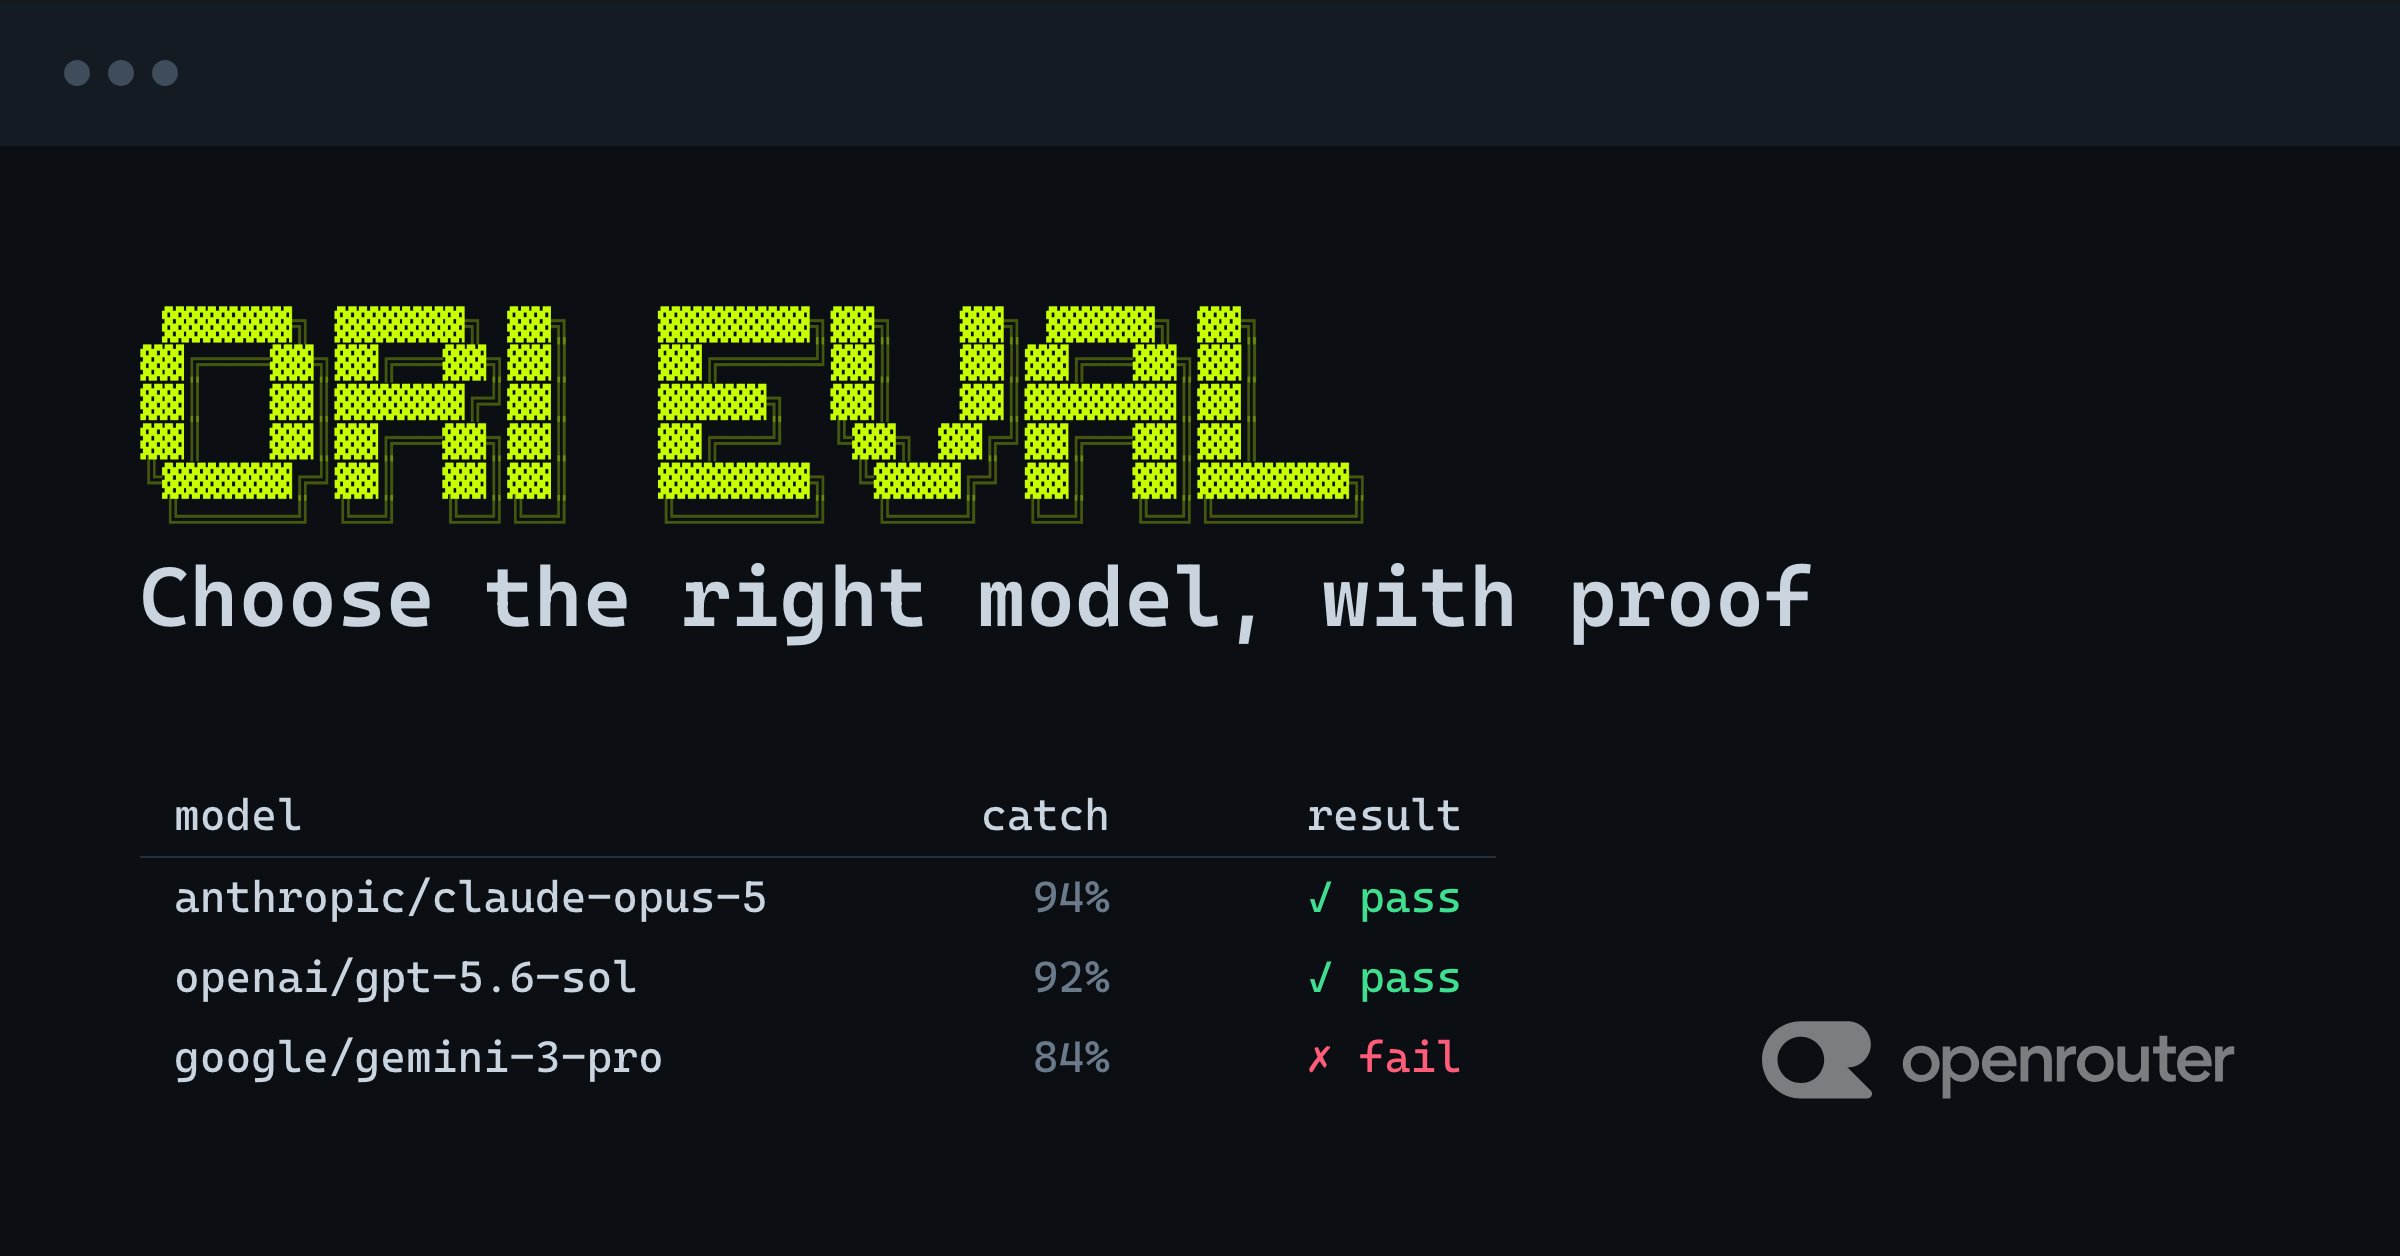
Ori Eval - выбирает модель на задачах вашего проекта
Универсально лучшей модели нет
Для кода, работы с инструментами и ответов на ваших данных победители могут быть разными. Ori Eval от OpenRouter превращает выбор модели в проверку прямо внутри coding-агента.
 создаёт временный
*.eval.ts и запускает его через Bun
проверяет, вызвал ли агент нужные инструменты и избежал ли запрещённых
оценивает завершение задачи, а открытые ответы передаёт отдельной LLM-судье
прогоняет несколько моделей в одинаковых условиях и показывает score, стоимость, время и рекомендацию
Можно описать баг обычными словами: Ori создаст падающий eval, после исправления он пройдёт, а проверку можно добавить отдельной задачей в GitHub Actions.
Есть и важная оговорка: качество вывода зависит от постановки задач, тестовых данных и критериев. LLM-судья помогает оценивать открытые ответы, но не превращает слабый eval в надёжный.
Как попробовать
Передайте coding-агенту команду:
curl -fsSL https://openrouter.ai/skills/spawn-ori-eval
Нужны macOS или Linux, Bun, Ori 0.3.0+ и авторизация OpenRouter. Официальный skill даёт ориентир 10-30 минут на полный запуск, но фактическое время может отличаться.